


16年間放置されていたSQLiteのバグを突き止めた方法
VPN構築・ネットワーク接続サービスのTailscaleが、自社のサービスが安定しない理由について数ヶ月にわたり調査を行ったところ、データベースのSQLiteに16年間潜在していたバグが原因であったことが判明しました。Tailscaleは「何が問題だったのか」「どう対応したのか」「SQLiteの不具合発見にどう貢献したか」についての説明を自社のブログにて公開しました。
https://tailscale.com/blog/sqlite-wal-reset-bug
Tailscaleは2022年からSQLiteを主要データベースとして利用していました。ユーザーがTailscaleのエンドポイントにアクセスすると「コントロールプレーン」に接続しますが、コントロールプレーンは複数の「シャード」で構成されています。安全なプライベートネットワーク「テールネット」はシャードのうちのどれかの上にありますが、状況によってシャード間をシームレスに移行することができる仕組みになっています。各シャードは自分が管理するテールネットに関する全情報を格納するSQLiteデータベースを持っています。単一のGoプロセスがSQLiteデータベースに排他的にアクセスし、テールネットのコントロールプレーンを処理します。

バックアップの仕組みは、数分おきにデータベースの完全なスナップショットを取得し、SQLiteファイル全体をAmazon S3のバケットにアップロードします。一連の構成は2023年初頭から何の問題もなく稼働してきましたが、2025年8月にS3バックアップでデータベースの破損が報告されたことから問題が始まりました。データベース破損は6ヶ月間で19件発生したものの、影響はコントロールプレーンの設定データのみでした。ただし破損が発生するたびにコントロールプレーンプロセスを停止してデータベースを修復または復元する必要があったため、対象シャードを内包するコントロールプレーンが利用できなくなるダウンタイムが発生しました。

問題解決に向けてまずは直近の変更を確認したものの、不具合に関連しそうな変更は見当たりませんでした。特にSQLiteと連携する低レベルコードはすべて数年前に記述されており、不具合発生がなかったためコードの修正は行われていませんでした。念のため隅々までコードの精査も行ったもののデータ破損を引き起こすような記述は見られませんでした。また問題が発生するトリガーも不明であったためバグの再現を行うことができず、ライブ環境でのフォレンジックテレメトリーに頼らざるを得ませんでした。さらに厄介なことに、インシデントが数時間置きに発生することもあれば数週間何も起こらないこともありました。簡単に修正できる問題ではないと判断したTailscaleはSQLiteの開発者とプロフェッショナルサポート契約を結び、協力して問題の検証を行うことになりました。
根本的な原因の調査中もプラットフォームは稼働しており、復旧を自動化したりダウンタイムを短縮したりするために必要な以下の措置を行いました。
・データベースが破損したら直ちにハードストップするようにシャードを構成する
・自動バックアップを導入する
・運用手順書とオンコールトレーニングを改善する
上記の取り組みにより応答時間を1時間未満に短縮することができ、さらに予期せぬ不具合の手掛かりを発見するきっかけともなりました。
データ損失やリスクなしにサービスを復旧させる方法を模索していたTailscaleはトランザクションログパイプラインを構築し、データベースを変更するすべてのSQLステートメントをログファイルにストリーミングことにしました。最新の正常なバックアップに対してこれらのトランザクションを再現するとデータベースが最新の状態に復元され、データベース破損が安全に回避されるという狙いがありました。

トランザクションログパイプラインの導入は期待した通りに機能したのみならず、不具合の手掛かりを得ることもできました。2件のインシデントでトランザクションログの再現に失敗し、詳しく調べたところ、あるトランザクションによって書き込まれコミットされたはずのデータが後のトランザクションには表示されないことが判明したのです。
明らかになってきた状況からSQLiteのチェックポイントプロセスのどこかに問題がある可能性が浮上しました。SQLiteデータベースは一連の「ページ」、つまり情報の小さなブロックで構成されています。データベースを更新する際はページの一部を更新された情報を含むものに置き換える必要があります。パフォーマンスと同時実行性を向上させるためにSQLiteは「Write-Ahead Logging(WAL)」を有効にして実行されます。つまり、新しいページはデータベースファイルに直接書き込まれず、一旦WALに書き込まれます。

新しいページをWALに無期限に書き込むことはできないので、ある時点でメインデータベースファイルにコピーして戻す必要があります。このプロセスが「チェックポイント」です。

通常はエンドユーザーや開発者が明示的にチェックポイントプロセスを実行する必要はなく、SQLiteが自動的にチェックポイントを実行するようになっています。しかしながらコントロールプレーンでは高速かつ一貫したバックアップを実行するためにチェックポイントプロセスを手動で制御するという非標準的なアプローチを行っています。
手掛かりの一つは、データベース破損の際にSQLiteが実際に利用可能なページよりも多くのページをWALからコピーしているとメトリクスが示していたことです。SQLiteはいくつかのレイヤーで構成されています。最上位層はパーサーおよびコードジェネレーターで、SQLステートメントをSQLiteの内部データ構造に変換します。これらのデータ構造はページャーに渡され、ページャーによってディスクに書き込まれる個々のページに分割されます。実際のディスクへの書き込みはOSインターフェース、つまり「仮想ファイルシステム」によって処理されます。このアプローチにより、さまざまなレイヤーをさまざまな実装で置き換えたり、既存のレイヤーをラップしてより多くの情報を取得したりできるわけです。
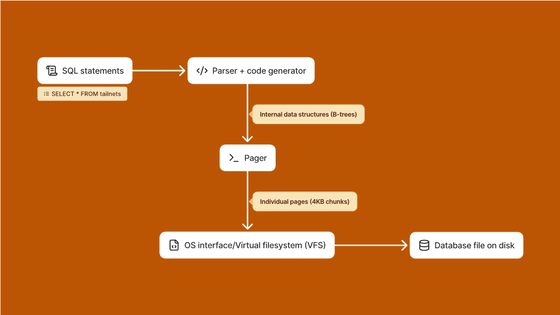
問題の診断を支援するためにSQLite開発者は追加のトレース情報とデータベースへの変更に関するログを書き込む仮想ファイルシステムのラッパーを作成しました。このラッパーにはSQLiteの仮想ファイルシステム(VFS)層を拡張・ラップするデバッグ・診断用VFSシム「tmstmpvfs shim」が含まれています。

ラッパーを本番環境にデプロイした直後に発生したデータベース破損でtmstmpvfs shimが残した追加のログにより、ついにSQLite開発チームはバグを発見・修正することができました。バグの原因はチェックポイントと書き込みトランザクションの間でまれに発生していたデータ競合であり、チェックポイント処理中に書き込みトランザクションが発生した場合に、チェックポイントプロセスが混乱しデータが失われるというものでした。
SQLite開発者は発見されたバグを「WAL-Resetバグ」と名付け、少なくとも16年間SQLiteに潜在していたと推定しました。まれにしか発生しない現象であるにもかかわらずTailscaleが度々バグに遭遇していた理由は、Tailscaleがチェックポイント作成プロセスを手動で制御し、かつ非常に積極的にチェックポイントを作成していたからでした。
SQLite開発者はWAL-Resetバグを修正したSQLite 3.52.0をリリースしましたが、別の問題が発生したため3.52.0を撤回してWAL-Resetバグの修正のみを含む3.51.3を改めて公開、最終的にすべての問題が解決したSQLite 3.53.0が公開されました。修正の適用後、最後の作業としてバグの要因であった「書き込みトランザクションとWALリセットの衝突」が発生してもデータベースが破損しなくなったことを確認する必要がありました。2ヶ月が経過した頃ついに「待望」のアラートが発生し、ようやくデータベース破損が発生しなくなったことを確認できました。

最終的にTailscaleはWAL-Resetバグの修正が有効であることを確認した後4ヶ月間データベースインシデントなしで運用を続けているとのこと。WAL-Resetバグにまつわる経験は「ありふれた技術」を非標準的な方法で実行することのリスクを浮き彫りにし、標準的な構成とパスの信頼性を再認識させるものでした。インシデントの解決はTailscaleとSQLiteの開発者双方にとって大規模な共同作業であり、SQLiteの長年のバグ修正とTailscaleのバックアップおよびリカバリープロセスの改善につながったと結んでいます。
