ChatGPTとの会話を人間が読む「Project Lily」が進行中、個人情報がレビュー担当者に届いてしまう可能性がある
OpenAIがChatGPTの応答品質を改善するため、実際のユーザーとChatGPTの会話を人間に読ませて評価する内部プロジェクト「Project Lily」を進めていると、海外メディアの404 Mediaが報じました。レビュー担当者にはユーザー名が表示されず、個人情報を隠す処理も行われますが、会話に含まれる個人的な情報が完全には取り除かれず、人間まで届く場合があるとのことです。
Inside ‘Project Lily’: The Humans Reading Your ChatGPT Chats

Hundreds of contractors are reportedly reading real ChatGPT conversations
https://thenextweb.com/news/chatgpt-human-reviewers-gdpr
ChatGPTのような生成AIを改善するには、大量の文章を学習させるだけでなく、生成した回答が適切だったかを人間が評価する作業も必要になります。Project Lilyでは数百人規模の契約スタッフが実際に行われた人間とChatGPTの会話を読み、回答の品質や問題点を評価しているとのこと。
ChatGPTは仕事や文章作成だけでなく、家族関係や健康、悩み事といった個人的な話題にも利用されています。404 Mediaは「実際のユーザーによる会話が評価対象となることについて、プライバシー上の大きなリスクがある」と指摘。同じ問題を報じているThe Next Webによると、レビュー画面ではユーザー名が匿名化されている一方、ChatGPTが保持しているメモリの要約が表示される場合があり、過去の利用内容やおおまかな居住地域に関する情報が含まれるケースもあるとのこと。
OpenAIはレビュー前に個人情報を減らすため「OpenAI Privacy Filter」を使用しています。OpenAIが公開しているPrivacy Filterの動作例では以下の画像のとおり、氏名や住所、メールアドレス、電話番号など個人の特定につながる情報がラベルに置き換えられます。

ただしPrivacy Filterで全ての個人情報を取り除けるわけではありません。OpenAI自身も「一般的ではない識別情報や文脈によって意味が変わる個人的な情報を見落とす場合がある」と説明しているほか、404 Mediaは「機密性の高い情報が残ったままレビュー担当者へ届く可能性をOpenAIが認めた」と報じています。
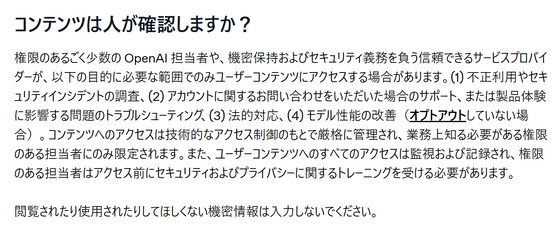
なお、OpenAIのプライバシーポリシーには、サービスの運営や改善に必要な範囲でベンダーやサービス提供事業者が個人データを処理する場合があると記載されています。また個人向けChatGPTでは、標準で会話がモデル改善に利用される設定になっています。
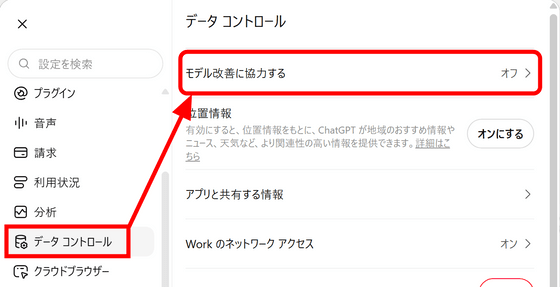
設定次第で会話データをモデル改善に利用されないようにすることも可能です。「設定」を開いて「データコントロール」から「モデル改善に協力する」をオフにすると、その後の新しい会話はモデルのトレーニングに利用されません。
一方、ChatGPT Business、Enterprise、Eduでは会話が標準でモデル改善に利用されない設定となっています。また「一時チャット」の会話もモデル改善には利用されず、通常は30日後に削除されます。
404 MediaがProject Lilyを巡り、人間がChatGPTとの会話を読む可能性をどこでユーザーに知らせているのかOpenAIに問い合わせたところ、OpenAIは人間によるレビューについて記載したヘルプページを案内したとのことです。