


わずか4Bの小型AIを強化学習したらPostgreSQLより1.81倍高速なクエリプランを生成できたという報告
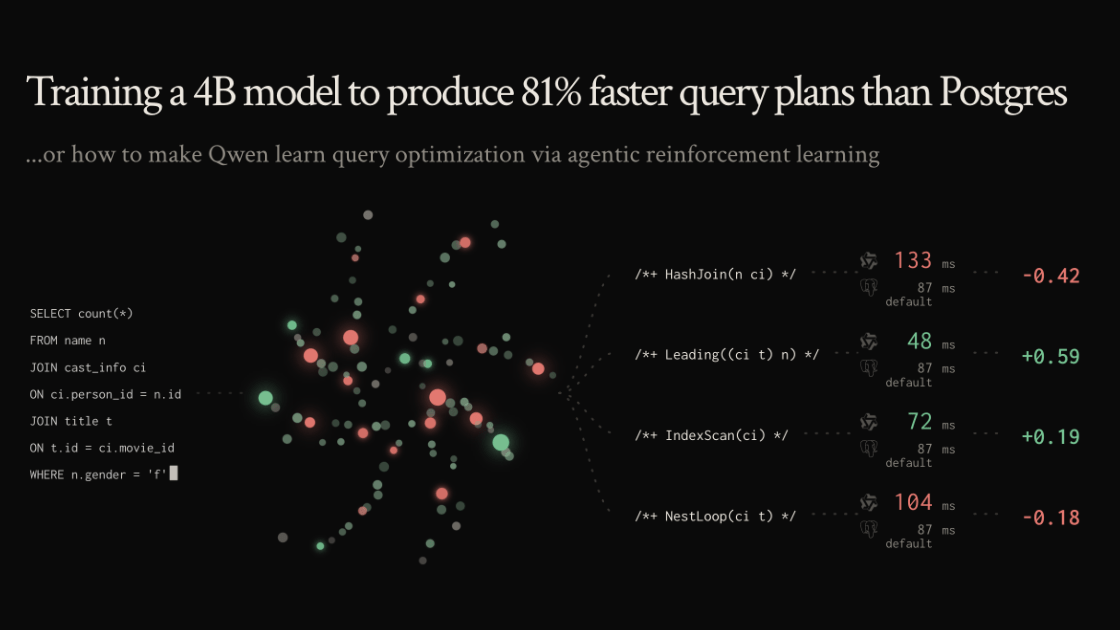
データベースにおけるクエリ最適化を小型LLMに肩代わりさせる研究を進めたところ、Postgresのデフォルトクエリプランを上回るパフォーマンスを発揮するクエリプランを生成できたと、バックエンドエンジニアのロハン・バンサル氏によって報告されました。
Training a 4B model to produce 81% faster query plans than Postgres - Rohan Bansal
データベース管理システム(DBMS)の重要な機能の一つが、データをより効率的に問い合わせるためのクエリプランを作成する「クエリ最適化」です。しかしながら、テーブル結合の順序決定のようなタスクはNP困難であり、PostgreSQLのような先進的なクエリオプティマイザーでさえ常に最適なプランを生成できるとは限りません。クエリオプティマイザーは実際のデータ行数ではなく統計情報に基づいた推定に依存するため、推定が正確かどうかがパフォーマンスに大きな影響を与える場合があります。
例としてIMDb(Internet Movie Database)のデータセットについて考えてみます。
-- An IMDb title (movie, series, episode, etc.) [~1M rows]
title (
id integer PRIMARY KEY,
title text,
production_year integer,
kind_id integer -- FK -> kind_type
)
-- Movie <> company junction table [~2M rows]
movie_companies (
id integer PRIMARY KEY,
movie_id integer, -- FK -> title.id
company_id integer, -- FK -> company_name.id
company_type_id integer, -- FK -> company_type.id
note text
)
-- A company's name, origin, etc. [~100k rows]
company_name (
id integer PRIMARY KEY,
name text,
country_code text -- '[us]', '[jp]', ...
)
-- Lookup table of company roles for a title [4 rows]
company_type (
id integer PRIMARY KEY,
kind text -- 'production companies', 'distributors', ...
)
-- Lookup table for what a title _is_ [7 rows]
kind_type (
id integer PRIMARY KEY,
kind text -- 'movie', 'tv series', 'episode', ...
)
データベースに例えば「2000年代に最も多くのタイトルをリリースした日本の企業はどこか?」と問い合わせる場合、以下のようなクエリを書くことになります。
SELECT cn.name,
COUNT(*) AS titles
FROM title AS t,
movie_companies AS mc,
company_name AS cn
WHERE t.id = mc.movie_id
AND mc.company_id = cn.id
AND cn.country_code = '[jp]'
AND t.production_year BETWEEN 2000 AND 2009
GROUP BY cn.name
ORDER BY titles DESC
LIMIT 10;
このクエリを実行すると、2000年から2009年の間にリリースしたタイトル数が多い順から並べた、10社の日本企業が出力されます。ただしデータベースがクエリ結果を取得するためにたどった道筋は必ずしも決まったものではなく「絞り込み条件」が大きくかかわってきます。結果が大きく絞られる「絞り込み条件」の影響を説明するため、先ほどのクエリから「日本の企業」フィルターや「期間」フィルターを除外し絞り込み条件のない状態にします。
SELECT cn.name,
COUNT(*) AS titles
FROM title AS t,
movie_companies AS mc,
company_name AS cn
WHERE t.id = mc.movie_id
AND mc.company_id = cn.id
GROUP BY cn.name
ORDER BY titles DESC
LIMIT 10;
するとクエリが参照している表は「t(title)」「mc(movie_companies)」「cn(company_name)」の3つであり、mcとcnは「mc.company_id = cn.id」によって結合され、tとmcは「t.id = mc.movie_id」によって結合されていることがわかります。したがって、最終的なクエリ結果を取得するためにはどちらの結合を先に行うかにより、以下のいずれかの道筋を通って3つの表すべてを結合させる必要があります。

次に、テーブルまたはクエリ結果のカーディナリティ、つまり含まれる行数について考えてみます。最終的なクエリ結果に関わるテーブルのカーディナリティが以下のとおりであると仮定します。
・cn(company_name):10万行
・mc(movie_companies):200万行
・t(title):100万行
結合を考慮すると以下のカーディナリティが得られます。

3つのテーブルを結合する順序に関係なく、常に同じ200万行が2番目の結合に渡されます。では絞り込み条件を元に戻しましょう。するとカーディナリティは以下のようになります。
・cn′:5000行(10万社のうち5%が日本企業であると仮定した場合)
・mc:200万行(絞り込み条件による変化なし)
・t′:20万行(100万タイトルのうち20%が2000年代に制作されたと仮定した場合)
結合を考慮すると以下のカーディナリティとなります。
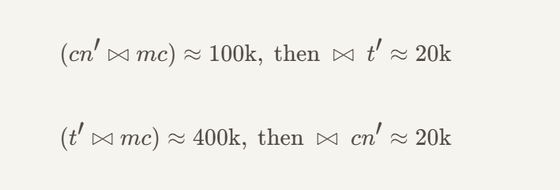
1つ目の結合順序では200万件のmovie_companiesエントリから日本企業である5%の企業に絞り込みます。一様分布を仮定すると、この結合によって約10万行が生成されます。この結果をフィルタリング済みのtitleテーブルと結合すると、そのうち2000年代に制作されたタイトルに該当する20%だけが残ります。
一方、2つ目の結合順序では200万件のmovie_companiesエントリから2000年代に作成されたタイトルの20%に絞り込みます。同じく一様分布を仮定すると、最初の結合によって約40万行が生成され、この40万行が2つ目の結合に渡されます。
つまり、1つ目の結合順序では2つ目の結合に渡される中間結果が約10万行であるのに対し、2つ目の結合順序では約40万行となるため、後者を選ぶと2つ目の結合で処理する行数が約4倍になります。
さらに話をややこしくするのが、テーブルを結合するアルゴリズムには以下の3つがあります。
・ハッシュ結合
・マージ結合
・ネストループ結合
また結合アルゴリズムに影響を及ぼすことから可換性についても考慮する必要が出てくるため、結果として3つのテーブルを結合する組み合わせは8通りとなります。

加えて、各テーブルをスキャンする方法には様々なものがあります。代表的なものとして以下の4つを考えます。
・シーケンシャル
・インデックス
・インデックス・オンリー
・ビットマップ
すべてを加味すると、先程のクエリを実行する方法は4608通りもあります。

なお、結合するテーブルが増えると組み合わせの数は爆発的に増加します。

重要な点は、PostgreSQLはクエリプランニング中に実際のカーディナリティをカウントできないということです。カーディナリティを知るには各テーブル・クエリ結果を実際に結合して結果の行数をカウントする必要がありますが、クエリオプティマイザーに求められる高速性は完全に損なわれてしまいます。クエリオプティマイザーの役目は完璧なコスト最小化ではなく多くのクエリで十分なパフォーマンスを出せることなので、PostgreSQLは統計情報を使用してカーディナリティを推定しています。PostgreSQLはシステムカタログ「pg_statistic」にデータの分散度などの統計データを格納しており、最も効率的なクエリプランを作成するために利用しています。ただし結合が絡んでくると話はややこしくなります。PostgreSQLはあるテーブルの行が別のテーブルにどのように分布しているかを知るすべを持たないので、ある値が1つ目のテーブルに出現する割合をそのまま2つ目のテーブルにも当てはめられると仮定する「一様分布の仮定」という考え方を用います。
「一様分布の仮定」はヒューリスティックとしては問題ないのですが、失敗すると影響は甚大なものとなります。先程挙げた結合順序の例を使用すると、200万件のmovie_companiesエントリのうち5%が日本企業のものであるという仮定のもとでフィルタリングを行いました。

しかし、もしその5%の日本企業がリリースした映画が実際には全映画の50%を占めていたとしたら、最初の結合で100万行が生成されかねません。初期の結合処理で誤った見積もりが1つあれば、影響が結合ツリー全体に波及し、他のすべての見積もりを台無しにする可能性があるということです。

PostgreSQLは常にコストが最も低い実行プランを選択しますが、ソースコードを変更しない限りそのコストモデルを変えることはできません。そこで、LLMによってクエリプランを改善できないかという着想から、PostgreSQLの拡張機能pg_hint_planを利用し、特定の実行プランを指示する「ヒント」をLLMに生成させる研究が始まりました。
pg_hint_planを利用する方法はSQL文の直前に構造化された「ヒント」をコメントとして追加するだけです。
/*+
HashJoin(a b)
SeqScan(a)
*/
EXPLAIN SELECT *
FROM pgbench_branches b
JOIN pgbench_accounts a ON b.bid = a.bid
ORDER BY a.aid;
上記のヒントはpgbench_accountsとpgbench_branchesの結合にHashJoinを使用し、pgbench_accountsテーブルに対してシーケンシャルスキャンを行うよう指定しています。実際の実行プランも指定された通りに動作しています。
QUERY PLAN
Sort (cost=31465.84..31715.84 rows=100000 width=197)
Sort Key: a.aid
-> Hash Join (cost=1.02..4016.02 rows=100000 width=197)
Hash Cond: (a.bid = b.bid)
-> Seq Scan on pgbench_accounts a (cost=0.00..2640.00 rows=100000 width=97)
-> Hash (cost=1.01..1.01 rows=1 width=100)
-> Seq Scan on pgbench_branches b (cost=0.00..1.01 rows=1 width=100)
(7 rows)
実験では、まず小規模な4Bモデル(Qwen3.8-4B-Distill)を使用し、教師ありファインチューニング(SFT)によってinspect_relation・get_column_stats・get_plan・evaluate_candidateといったツールを提供する「qo-agent」ハーネスの言語を学習させました。なお教師モデルにはGPT-6 AstraかQwen 3.8 2.4Tのどちらを選ぶかを多面的に評価した上でGPT-6 Astraを採用しています。

SFTの後、モデルはエージェントベースの強化学習(RL)によってさらに訓練されました。RLではモデルが生成したクエリプランを実際の実行時間で評価し、より良いプランを生成するようにモデルの重みを更新しました。RLのプロセスではノイズの多い測定環境でも信頼性の高い報酬設計と、学習を安定させるためにカスタマイズしたGRPO(Group Relative Policy Optimization)バリアントが重要であることが示されました。

訓練の結果、4BモデルはSFTとRLの両方を通じてPostgreSQLのデフォルトプランを大幅に上回るクエリプランを生成することに成功しました。特に、結合負荷の高い113個のクエリからなる「結合順序ベンチマーク(JOB)」データセットにおいて幾何平均で1.81倍のスピードアップを達成しました。つまり、モデルが単にツールの使い方を学んだだけでなく、結合順序の変更・スキャン方法の最適化・並列実行の活用といったクエリ最適化における有効な戦略を学習できたことを示唆しています。

バンサル氏の研究を通じて、小規模なオープンウェイトモデルであっても適切な訓練とインフラストラクチャによって、特定のドメインタスクにおいて最先端モデルに匹敵あるいは上回るパフォーマンスを発揮できる可能性が示されました。
