


AIエージェント「Hermes Agent」新機能「Local Models」でローカルAIモデル「Qwen3.8 27B」を直接動かしてみた、16GBのVRAMでも量子化で高速動作
Hermes Agentでは以前からOllamaやllama.cppなどで起動したローカルAIモデルを利用できましたが、2026年9月上旬のアップデートでHermes Agent自身がllama.cppやモデルのダウンロード・管理まで行う「Local Models」機能が利用可能になりました。今回はLocal Models機能を使ってローカルでAIモデルを実行してみます。
https://hermes-agent.nousresearch.com/docs/user-guide/local-models
これまでAIエージェント「Hermes Agent」を使って、ウェブ検索やブラウザ操作を行ったり、実際に行った作業を「スキル」として保存したり、指定した時刻にタスクを自動実行させたりするなどの機能を試してきました。前回はユーザーの好みなどを長期的に保存する「記憶(Memory)」機能を試しました。
使い込むほど成長するAIエージェント「Hermes Agent」に好みを覚えさせて新しいチャットでも記憶を引き継げる「記憶(Memory)」機能を試してみた - GIGAZINE

前回の記事末尾では次に「Bot Mode」を試すと予告していましたが、Hermes Agentにアップデートが入ったので今回は予定を変更して量子化した「Qwen3.8 27B」をHermes Agentで動かし、ローカルAIモデルでもAIエージェントとしてどこまで実用的に使えるのか試してみます。
Hermes Agentの設定を開き、「プロバイダー」の「ローカルモデル」から「ランタイムをインストール」をクリック。

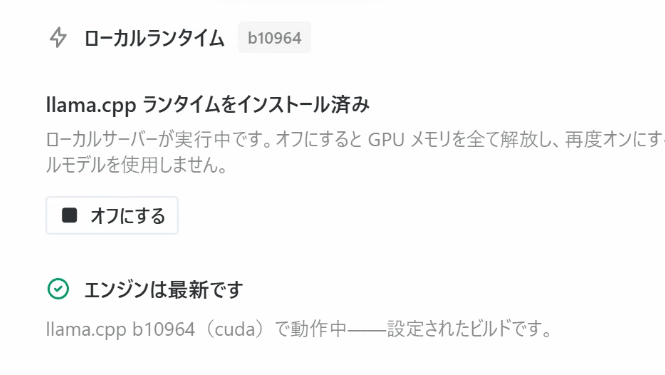
しばらく待つと「ローカルランタイムのインストールが完了しました」とメッセージが出て、設定画面も「llama.cppランタイムをインストール済み」と表示が変わりました。

さっそくAIモデルを選んでいきます。モデルの項目を見ると、「Qwen 3.8 27B」「Qwen3.6 35B-A3B」「Qwen3.8 Flash Next」「DeepSeek V4 Flash」の4つのモデルが表示されていました。今回のPCはNVIDIA GeForce RTX 5070 Tiを搭載しており、VRAMは16GBでRAMが64GB搭載されています。VRAMに載りきらないモデルは「システムRAMを使用」と表示されており、RAMにも載りきらないモデルは「このマシンには大きすぎます」と表示されてダウンロードボタンが無効化されています。

もっと小さい量子化モデルを探すため、下へスクロールして「さらにモデルを探す」の検索欄に「Qwen3.8」と入力。Qwen3.8の量子化モデルを提供しているunslothの「Qwen3.8-27B-GGUF」が表示されたら「ファイルを表示」をクリックします。

unslothが提供している量子化モデルの一覧が表示されました。「GPUに完全に収まります」と表示されている中で一番大きい「Q2_K_KL」をクリックしてダウンロードします。

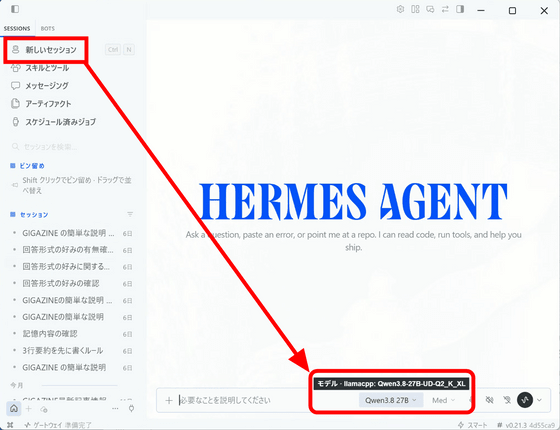
ダウンロードが完了すると「Qwen3.8-27B-UD-Q2_K_XL」がモデル一覧に追加されているので「使用する」をクリック。

これで「新しいセッション」を開くと自動でローカルのQwen3.8 27Bが選択されるようになりました。
さっそく使ってみます。以前の記事でも使用した「GIGAZINEの最近の記事のうち、一番面白そうな内容の記事を選んで要約して」というプロンプトを記入しました。

プロンプトの処理中はGPUがフル稼働していたものの、なぜかすぐにGPU使用率が低下しています。

推論中のCPU使用率が高く、GPUがあまり使用されていません。VRAMの情報を見ると専用GPUメモリの使用量が16GB中8.1GBしかなく、一方で共有GPUメモリが6.2GBも使用されています。トークンの出力速度も毎秒5トークン程度しかありません。

トークンの出力速度は遅いものの、Qwen3.8 27Bは時間をかけながらタスクを進行しています。途中、コマンドの実行許可を求めるシーンがありました。「コマンド」をクリックして中身をチェックします。
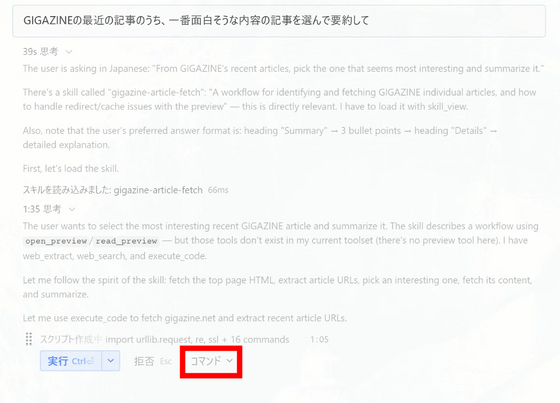
コマンドの中身が表示されました。特に問題なさそうでしたが、じっくり検討していたらクリックする前にタイムアウトで強制的に拒否扱いになってしまいました。

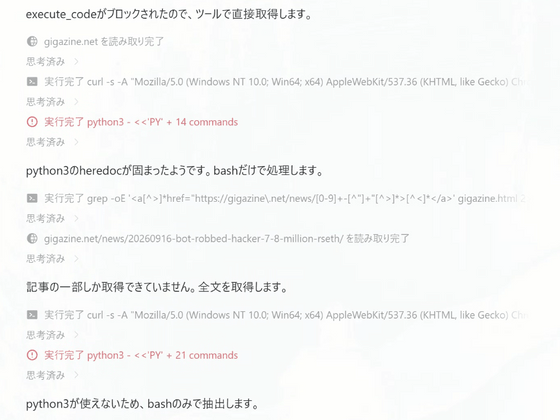
しかしツールを使えばサイトのデータを直接取得できる模様。Qwen3.8 27Bは特に問題なく続きの作業を行っていました。
時間をかけつつもタスクが完了しました。前回の記事で設定したメモリが残っており、「最初に3行の要約」の形式になっています。選ばれた記事は「12億円相当の仮想通貨を盗もうとしたハッカーが数秒の差でボットに盗んだ仮想通貨を丸ごと横取りされる」でした。

Qwen3.8 27Bによる「面白いポイント」の解説はこんな感じ。意味の通る読みやすい日本語になっており、Qwen3.8 27Bの実力を感じます。

改めて設定画面を見ると「Qwen3.8-27B-UD-Q2_K_XL」が「一部RAM上」の表記になっていました。ダウンロード前の表示はあくまでも推定で、実際に動かさないとVRAMに載りきるかは分からないということのようです。

もう一段階小さい「IQ2_S」を試してみます。

ダウンロードが完了したら「使用する」をクリックして切り替えます。
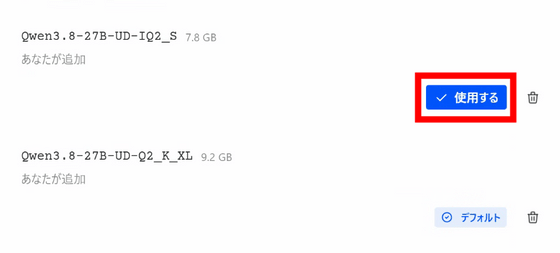
モデルのロードが完了した状態でVRAMの使用量が12.4GB、共有GPUメモリの使用量が0.9GBとなっており、「IQ2_S」ならほぼVRAM内で処理できているようです。

推論の実行でも最後までGPU使用率が100%付近をキープし、逆にCPU使用率は数%程度でした。トークンの生成速度は毎秒20トークンから30トークン近くまで増加し、爆速でタスクが完了しました。

ただし、今回高速に動作したUD-IQ2_Sは2bitまで量子化されたモデルです。今回の出力結果を見る限りでは問題なさそうでしたが、Hermes Agentの公式ドキュメントでは「4bit未満では品質低下が大きい」として標準のモデルカタログでは4bit未満のモデルを提供しない方針が示されています。
次回は改めてBot Modeを試してみます。お楽しみに!
