


画像生成・編集AI「Qwen-Image-2.1」が無料のオープンモデルとして登場したので使ってみた、日本語プロンプト対応&透過PNG画像も生成可能
中国企業のAlibabaが画像生成AI「Qwen-Image-2.1」を2026年9月20日に公開しました。Qwen-Imageシリーズとしては久しぶりのオープンモデルで、無料でダウンロードしてComfyUIなどの実行環境で画像生成および編集を実行可能。「透過PNG作成機能」や「複数の参照画像をもとにした画像生成機能」などを備えているとのことなので、実際にPCでローカル実行してみました。
https://qwen.ai/blog?id=qwen-image-2.1
Qwen/Qwen-Image-2.1 · Hugging Face
https://huggingface.co/Qwen/Qwen-Image-2.1
Qwen-Imageシリーズは初期の頃はオープンモデルとしてリリースされていましたが、2026年2月登場のQwen-Image-2.0や2026年7月登場のQwen-Image-3.0はクローズドモデルとして展開されました。今回登場したQwen-Image-2.1はバージョンが逆戻りしたものの、オープンモデルとして公開されており、無料でダウンロードしてローカルで実行することができます。
Alibabaが公開した「各種画像生成AIのベンチマークスコアとパラメーター数をまとめた図」が以下。Qwen-Image-2.1は2026年1月に登場したQwen-Image-2512より小さい70億パラメーターのモデルですが、クローズドモデルであるGoogleのNano Banana 2.0やOpenAIのGPT-Image-1.5より高性能とされています。

すでにComfyUIで使用可能になっているので使ってみます。まずテンプレート一覧から「Qwen Image 2.1:テキストから画像へ」を探してクリック。

「モデルが足りない」というエラーが表示されるので「詳細を表示」をクリック。

diffusion modelの「qwen_image_2.1_int8_convrot.safetensors」、テキストエンコーダーの「qwen3vl_8b_int8_convrot.safetensors 」、VAEの「qwen_image_2.1_vae_bf16.safetensors」をダウンロードするように促されるので「すべてダウンロード」をクリックします。

ダウンロードが完了したらComfyUIを再起動もしくは画面更新。続いて、プロンプト入力欄に画像の説明を入力して「実行する」をクリックすると画像を生成できます。プロンプトは日本語でもOKです。
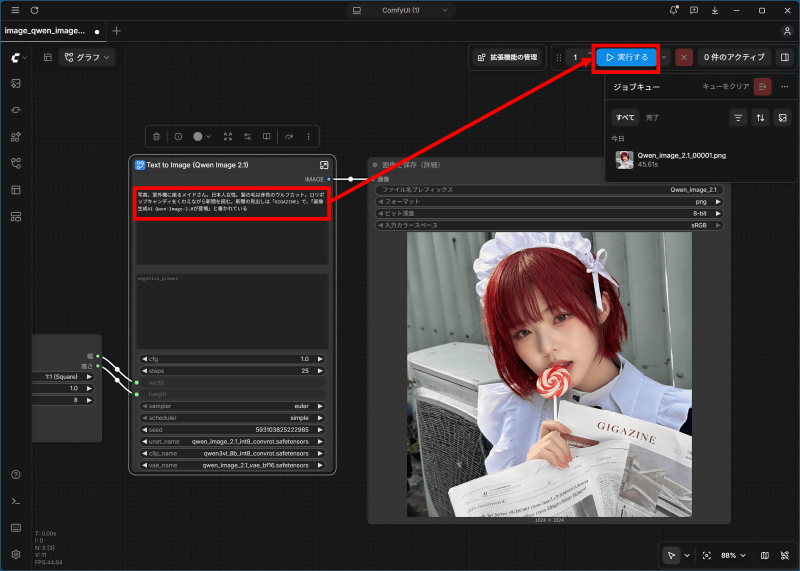
『写真。室外機に座るメイドさん。日本人女性。髪の毛は赤色のウルフカット。ロリポップキャンディをくわえながら新聞を読む。新聞の見出しは「GIGAZINE」で、「画像生成AI Qwen-Image-2.0が登場」と書かれている』というプロンプトで生成した画像が以下。人間がかなりリアルなのが特長的。一方で、新聞の文字の指示は守れておらず、室外機も歪んでいます。

同じプロンプトでシード値を変更して生成。「画像生成AI Qwen-Image-2.0が登場」というテキストが正しく反映されました。ChatGPTやGeminiなどのオンラインサービスと比べると品質が低めですが、生成回数が無制限なのでシード値を変更しながら何度も生成していると「当たり」の画像を生成できることがあります。

参考までに、「グラフィックボード:Intel Arc Pro B70 Creator 32GB」「CPU:AMD Ryzen 5 7600X」という構成のPCを使って「解像度:1024×1024ピクセル」「ステップ数:25」という設定で生成した結果、初回の画像生成に約45秒、2回目以降は約30秒かかりました。

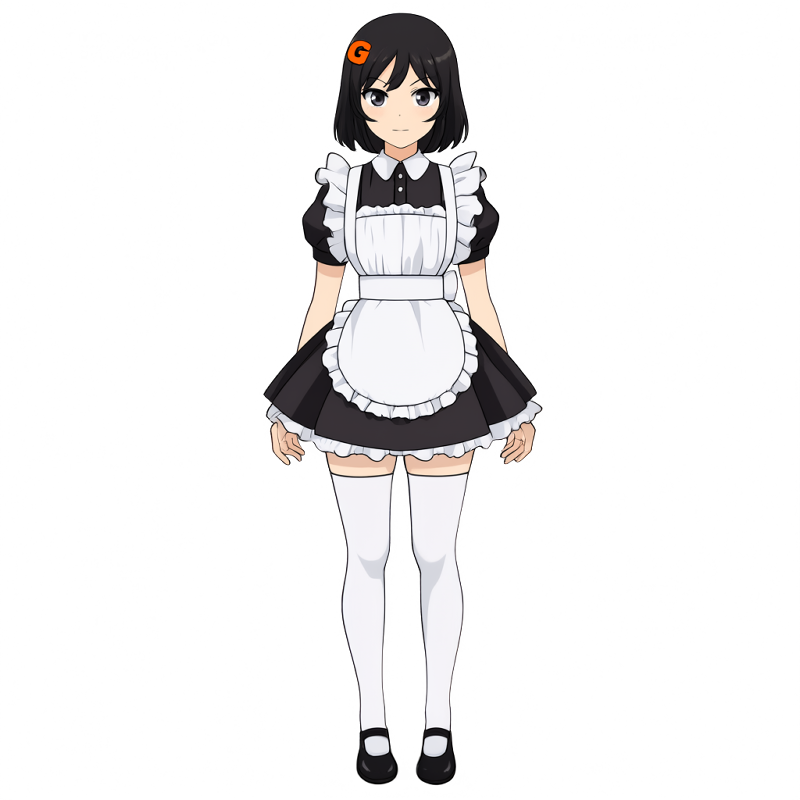
Qwen-Image-2.1は透過PNG画像の生成にも対応しています。特に複雑な設定は必要なく、プロンプトに「透過PNG」などのワードを含めればOKです。

『透過PNG。デフォルメされたメイドさんの全身イラスト。髪の毛は黒色のショートカットで、オレンジ色の「G」という形状のヘアピンを着用。直立して正面を向いた姿勢。背景は透過』というプロンプトで生成した画像が以下。以下の画像は記事用に縮小して透過状態が失われていますが、画像をクリックするとオリジナルの透過PNG画像を確認できます。
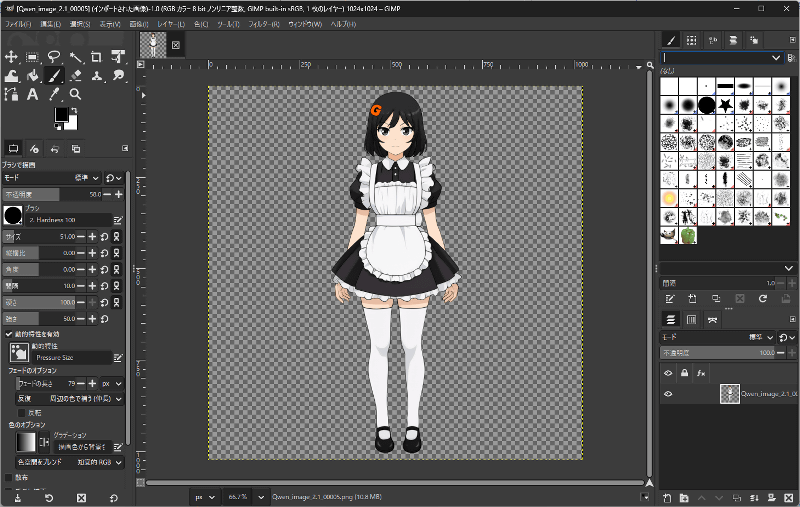
GIMPで開いてみるとこんな感じ。背景がしっかり透過されています。
Qwen-Image-2.1の画像編集機能も試してみます。ComfyUIのテンプレート一覧にある「Qwen Image 2.1:画像編集」を探してクリック。

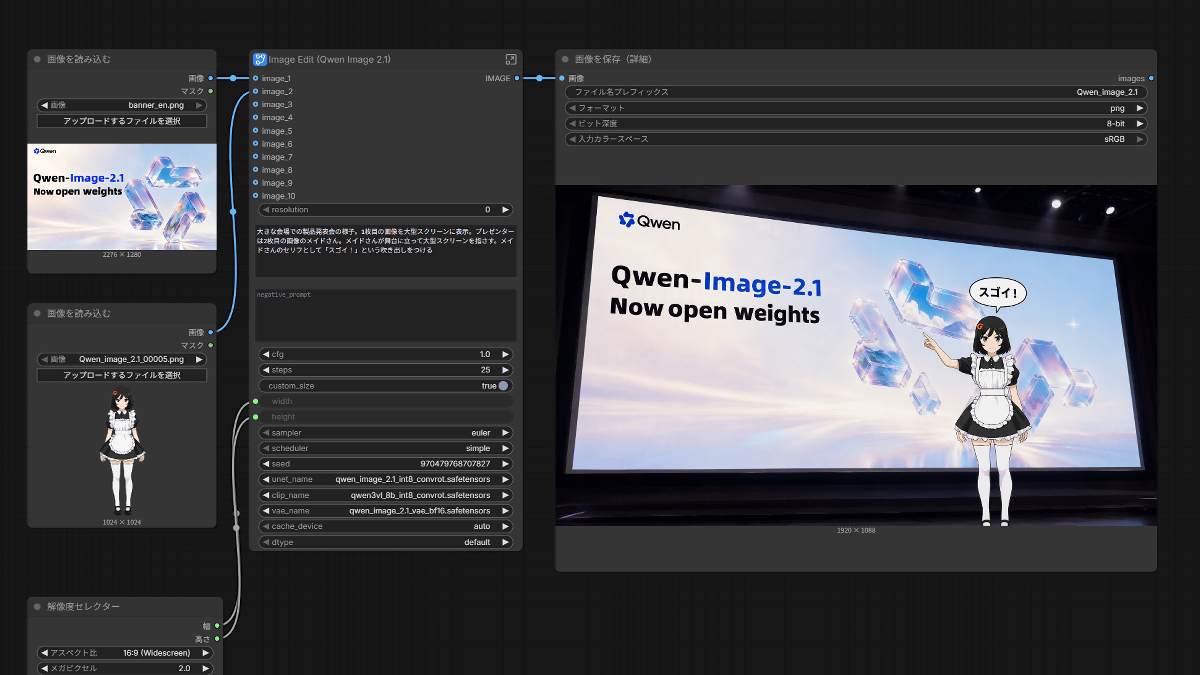
元画像とテキストプロンプトを入力して生成します。今回はAlibabaのQwen-Image-2.1発表ブログに掲載されているアイキャッチ画像と、先ほど生成した透過PNG画像とともに『大きな会場での製品発表会の様子。1枚目の画像を大型スクリーンに表示。プレゼンターは2枚目の画像のメイドさん。メイドさんが舞台に立って大型スクリーンを指さす。メイドさんのセリフとして「スゴイ!」という吹き出しをつける』というテキストを入力しました。

生成結果はこんな感じ。「スクリーンが湾曲しているのに、文字が湾曲していない」「アイキャッチ画像の左側の構造体が崩れている」「腕が多い」といった問題はあるものの、おおむね指示通りです。

ただし、上記のプロンプトでは成功画像が出る確率が低く、何枚も生成して成功画像を選ぶ必要がありました。失敗画像の例はこんな感じ。ローカル画像生成界隈では「LLMを使ってプロンプトを画像生成AIに適した形に整形する」というプロンプトエンハンサーを用いる手法が流行しているので、Qwen-Image-2.1でもプロンプトエンハンサーの使用を検討するのが良さげです。

なお、Qwen-Image-2.1のライセンスには商用利用を禁止する条項が含まれていますが、Alibabaの公式Xアカウントは「Qwen-Image-2.1で作成した画像の権利はユーザーに属する」と明言しています。
Hi there, thanks for your question! 👋 Just a quick clarification: Outputs are not part of the licensed Materials. Users retain the rights to images and other content they generate using the model.— Qwen (@Alibaba_Qwen) September 21, 2026
