「Jetson AGX Xavier」レビュー(2) セットアップ&ベンチマーク編 エッジを知能化する超小型AIコンピュータの実力は本物か?


では、どのくらいパワフルなのでしょうか?
●Jetson AGX Xavierはどのくらい凄い?
まずは「Jetson AGX Xavier」の性能を確認するため「DeepStream SDK」のデモを動かしてみました。

●ベンチマーク測定
セットアップが終わったところでベンチマーク測定をしてみました。
最初にUnixBench5.1.3(https://github.com/kdlucas/byte-unixbench)でCPUのスピード計測として今回はHost PC, AGX Xavier(30Wモード), RaspberiPi3+の3台で整数演算(Dhrystone)、浮動小数点演算(Whetstone)のベンチマークを比較してみます。


UnixBench5.1.3での ベンチマーク結果
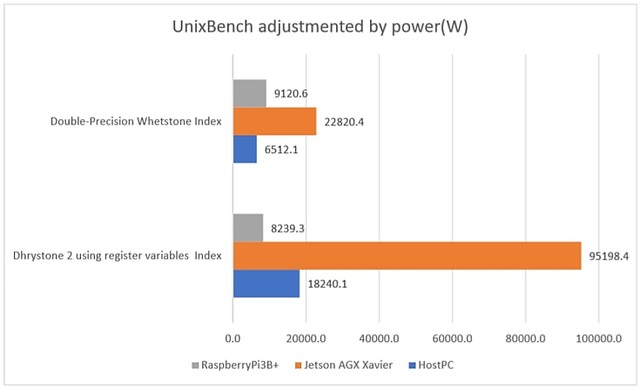
CPUもOSも消費電力も全く違うPCを横並びで評価するのは非常に乱暴ですが、特筆すべきはJetson AGX Xavierは整数演算ではHost PCを上回っています。
Jetsonシリーズはエッジコンピューティング製品ということで、消費電力で上のデータをならした結果は以下の通りで、消費電力あたりのパフォーマンスはPCを大きく引き離します。
●GPUのパフォーマンス比較
GPUのパフォーマンスはCUDAのサンプルnbodyでベンチマーク測定を行いました。(Raspberry PiはNVIDIA GPUではないため計測対象から除外)
計測結果だけを見るとHost PC + GTX 1050 TiがJetson AGX Xavierで搭載されているVolta GPUの約1.7倍というパフォーマンスが出ています。ただし、消費電力で合わせてみるとJetson AGX Xavierのパフォーマンスが格段に良いことがわかります。


●ディープニューラルネットワークの比較
ここまではJetson AGX Xavierで今回搭載された2つのDLAの計測ができていません。
今回はTensorRTのgiexecというサンプルを使ってGoogLeNetというモデルを使った画像分類のベンチマーク結果をもとに1秒当たりの画像処理量を比較した結果が以下の通りです。
消費電力で合わせなくとも、Volta GPU+2つのDLAを搭載したJetson AGX XavierはGTX 1050 Tiの性能を超えて秒間2,273枚の画像分類処理を可能にしています。これが冒頭のDeep Stream SDKデモのパフォーマンスにつながるということです。

●動かしてみた所感
Jetsonシリーズを今回初めて触りましたが、DeepStream SDKのデモを自分で動かしてみて、今回搭載された2個のDLAのパフォーマンスも含めJetson AGX Xavierのエッジ処理の可能性に正直驚きました。
最近の流れとして、Core MLやAuto MLなどサーバで学習データをトレーニングさせてエッジで処理をするのが流行ですが、正直、どの小型デバイスを使ってもパフォーマンス不足、業務などの実用にはイマイチな感がありました。
しかしJetson AGX Xavierの登場でAIエッジコンピューティングの性能、特にエッジでのストリーミングデータに遅延なくAI処理を行えるデバイスが出てきたことは、新しい利用の可能性がますます広がると感じました。
引き続きAIやロボット関連でどのような可能性があるのか次回以降でさらに探っていきたいと思います。
お楽しみに。
(高橋一行)
